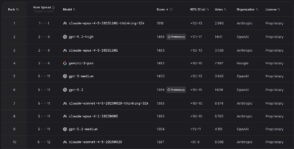
Les classements des modèles d’IA se sont affinés au cours des deux dernières années. Initialement génériques, ces classements offrent aujourd’hui une vision précise des domaines de compétence des modèles, révélant ceux qui excellent dans des tâches spécifiques. Un exemple notable est le WebDev Leaderboard, établi par LMArena, qui évalue les capacités des IA, notamment dans le codage et le développement web. Faisons le point.
OpenAI, Google et Anthropic dominent le top 10
Décembre 2025 marque une intensification de la concurrence entre les développeurs de solutions d’IA dans le secteur du développement web et logiciel. Des modèles dédiés au vibe-coding et agents spécialisés émergent, avec un nombre croissant d’entreprises lançant des versions de leurs modèles d’IA pour le codage. Qui se distingue dans ce classement ? À l’issue de l’année, trois titans se démarquent.
En tête, le modèle Thinking de Claude Opus 4.5 d’Anthropic se positionne comme le leader, souvent reconnu pour ses performances en codage. Le modèle classique Claude Opus 4.5 se retrouve en 3ème position. Anthropic place également Claude Sonnet 4.5 Thinking en 7ème, Claude Opus 4.1 en 8ème et Claude Sonnet 4.5 en 10ème. Au total, l’entreprise rafle 5 des 10 premières places. OpenAI répond avec le GPT-5.2 High, classé 2ème, ainsi que le GPT-5 Medium à la 5ème position, suivi du GPT-5.2 en 6ème et GPT-5.1 Medium en 9ème. Enfin, Gemini 3 Pro termine 4ème, complétant ainsi le top 10.
Voici les 10 modèles d’IA les plus performants pour le codage et le développement web en décembre 2025 :
- Claude Opus 4.5 Thinking : 1519 (score Elo)
- GPT-5.2 High : 1486
- Claude Opus 4.5 : 1483
- Gemini 3 Pro : 1482
- GPT-5 Medium : 1400
- GPT-5.2 : 1399
- Claude Sonnet 4.5 Thinking : 1395
- Claude Opus 4.1 : 1395
- GPT-5.1 Medium : 1394
- Claude Sonnet 4.5 : 1387
Découvrir le classement complet
Évaluation des performances par la WebDev Arena
Pour assurer une évaluation objective des modèles d’IA, LMArena utilise des confrontations en aveugle. Chaque modèle reçoit la même instruction, et les utilisateurs doivent désigner la réponse la plus pertinente sans connaître l’identité des modèles. Ce système génère un classement Elo, similaire à celui du jeu vidéo : une victoire contre un modèle bien classé permet de gagner des points, tandis qu’une défaite contre un modèle moins performant entraîne des pertes. Le tableau reste dynamique, évoluant au rythme des votes.