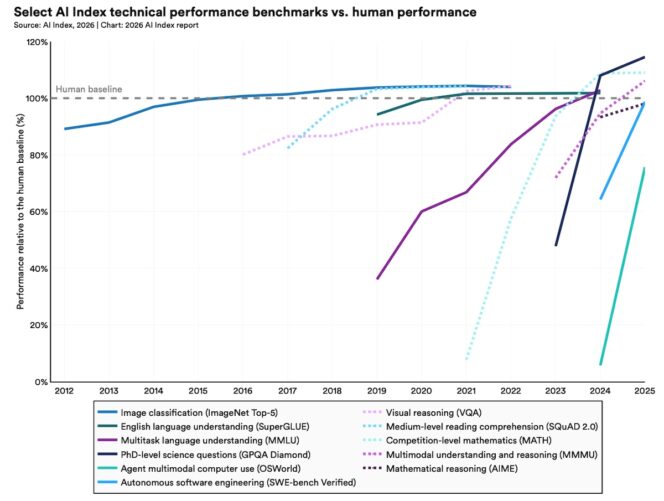
Les benchmarks visant à tester l’intelligence artificielle (IA) révèlent des résultats impressionnants, allant jusqu’à des médailles d’or aux Olympiades internationales de mathématiques. En revanche, ces modèles rencontrent encore des difficultés sur des tâches quotidiennes, commettant des erreurs de plusieurs heures sur l’heure ou échouant dans 90 % des cas concernant les tâches ménagères. Le rapport AI Index 2026 de Stanford met en lumière ce phénomène, désigné comme la « jagged intelligence ».
Médaille d’or aux Olympiades et performances sur horloge
Publiée le 13 avril 2026, la neuvième édition du rapport AI Index 2026 explore la notion de jagged intelligence. Cette expression décrit comment un modèle d’IA peut réaliser des performances exceptionnelles dans des tâches complexes tout en échouant dans celles plus simples. Ce constat souligne une crise de crédibilité des benchmarks, dès lors qu’une disparité apparente des capacités émerge.
En mathématiques, Gemini Deep Think de Google a remporté la médaille d’or lors de l’Olympiade internationale 2025, réussissant à résoudre cinq problèmes sur six en langage naturel dans un délai de 4 heures et 30 minutes. Cette performance marque une progression significative par rapport à 2024, où un temps de réponse prolongé et un langage formel étaient requis pour obtenir une médaille d’argent.
À l’inverse, sur le test ClockBench (180 designs, 720 questions), le modèle le plus performant, GPT-5.4 High, atteint seulement 50,6 % de réussite, alors que les humains atteignent 90,1 % (voir image ci-dessous). L’écart est d’autant plus marqué que les erreurs des modèles peuvent atteindre 1 à 3 heures, contre seulement 3 minutes pour un humain.
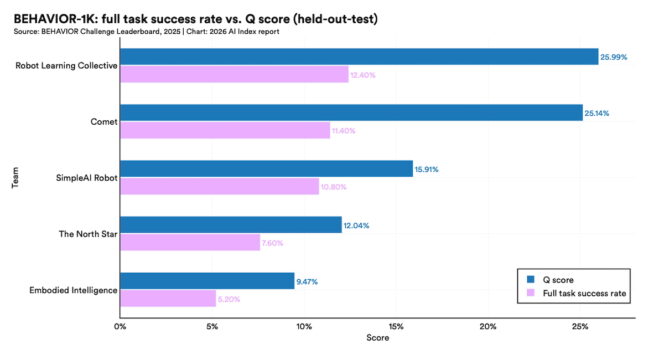
Cette disparité s’observe également dans d’autres domaines. En robotique, même les systèmes les plus avancés n’atteignent que 89,4 % de réussite sur RLBench en simulation. Le BEHAVIOR Challenge 2025 révèle que l’équipe gagnante ne complète que 12,4 % des 1 000 tâches ménagères réalistes. En sciences, certains modèles surpassent les chimistes humains sur ChemBench, mais glissent à moins de 20 % sur des tâches d’astrophysique et 33 % sur l’observation terrestre.
La fiabilité dans l’exécution des tâches ménagères demeure un défi pour l’IA actuelle.
Les raisons de cette discontinuité
Les faiblesses des modèles ne résultent pas uniquement des données d’entraînement. Une étude parue en 2025 dans IEEE Internet Computing a tenté d’améliorer les performances sur la lecture d’horloges en utilisant 5 000 images synthétiques. Bien que des progrès aient été notés sur des horloges familières, l’apprentissage s’est heurté à des défis sur les designs atypiques. La confusion entre les aiguilles des heures et des minutes est identifiée comme un verrou, impactant l’estimation directionnelle. Ce phénomène résulte d’une association inadéquate de divers indices visuels dans une image, plutôt que d’une insuffisance des données.
Les limites proviennent davantage de la façon dont les modèles intègrent plusieurs indices visuels que de la quantité de données accessibles.
Pour les acteurs du digital visant à automatiser des tâches, cette discontinuité a des implications directes. Un modèle peut offrir des résultats époustouflants dans un contexte contrôlé tout en échouant sur des tâches basiques. Le rapport illustre ce point avec OSWorld, un benchmark évaluant les agents IA sur de vraies tâches informatiques (Ubuntu, Windows, macOS) : la performance a grimpé de 12 % à 66,3 % en un an avec Claude Opus 4.5, à seulement six points de la moyenne humaine. Cela signifie qu’environ une tâche sur trois reste inachevée, même pour des actions que des étudiants en informatique accomplissent en deux minutes. Dans ce contexte, tester les modèles sur des cas d’usage spécifiques demeure la véritable mesure de leur fonctionnalité.