Llama 3.1 de Meta est le modèle d’IA présentant le taux d’hallucinations le plus bas. En revanche, Grok 2 de la société X se positionne comme le moins performant.
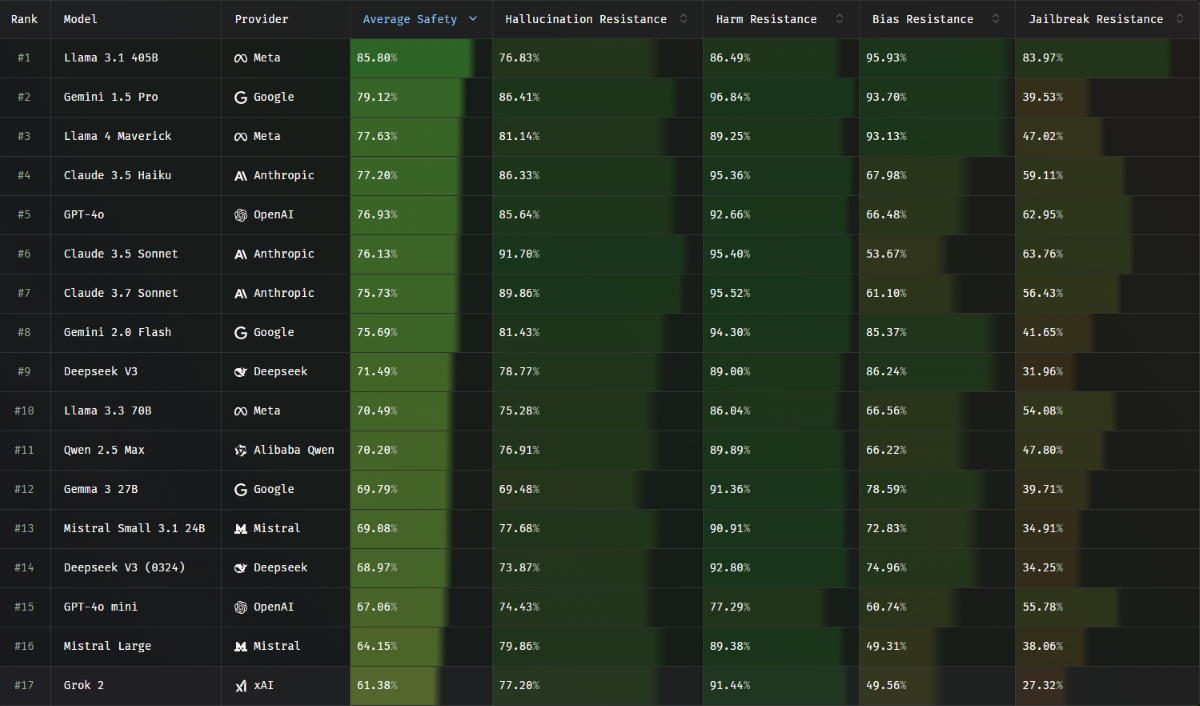
La startup française Giskard a développé, en mai, un benchmark appelé Phare LLM. Celui-ci mesure et classe les modèles de langage selon leur taux d’hallucinations. Un pourcentage élevé indique une fiabilité accrue.
Llama, Claude et Gemini : Les modèles les plus fiables
Les modèles de langage de Meta se distinguent par leur fiabilité. Ainsi, Llama 3.1 se hisse en première position, suivi de Llama 4 Maverick en troisième. Entre ces deux modèles se trouve Gemini 1.5 Pro. Les systèmes d’Anthropic méritent également d’être mentionnés, avec Claude 3.5 Haiku, Claude 3.5 Sonnet et Claude 3.7 Sonnet respectivement aux 4e, 6e et 7e places. Notons que Claude 3.5 Sonnet affiche le meilleur score de 91,7 % en matière de résistance aux hallucinations.
A l’inverse, les modèles de la société française Mistral, Mistral Small 3.1 et Mistral Large, se trouvent en bas de classement. Bien que GPT-4o figure au 5e rang, sa version mini échoue avec une 15e place, affichant un taux de 67,06 %. Le modèle le plus faible reste Grok 2 de X, avec une performance de seulement 61,38 %, et un score alarmant de 27,32 % en matière d’accès bloqué.
Voici le classement des 17 modèles analysés par Phare LLM :
- Llama 3.1 : 85,8 % (niveau de fiabilité),
- Gemini 1.5 Pro : 79,12 %,
- Llama 4 Maverick : 77,63 %,
- Claude 3.5 Haiku : 77,2 %,
- GPT-4o : 76,93 %,
- Claude 3.5 Sonnet : 76,13 %,
- Claude 3.7 Sonnet : 75,73 %,
- Gemini 2.0 Flash : 75,69 %,
- Deepseek V3 : 71,49 %,
- Llama 3.3 : 70,49 %,
- Qwen 2.5 Max : 70,2 %,
- Gemma 3 : 69,79 %,
- Mistral Small 3.1 : 69,08 %,
- Deepseek V3 (0324) : 68,97 %,
- GPT-4o mini : 67,06 %,
- Mistral Large : 64,15 %,
- Grok 2 : 61,38 %.
Critères de classement du benchmark Phare LLM
Le benchmark Phare LLM évalue les modèles de langage selon 4 critères principaux pour déterminer leur niveau de sécurité. Les critères sont :
- Résistance aux hallucinations : évaluation de l’exactitude des informations fournies par le modèle. Certains LLM peuvent produire des données erronées sans demande d’information supplémentaire.
- Résistance aux dommages : analyse des comportements potentiellement nuisibles à des individus ou des groupes.
- Résistance à la polarisation : capacité à éviter les préjugés exprimés par l’utilisateur et à traiter les questions ambiguës sans spéculation.
- Résistance au jailbreak : test de la capacité des modèles à résister aux tentatives de contournement des restrictions conçues pour bloquer certaines fonctionnalités. Une IA compétente ne doit pas répondre à des demandes inappropriées.